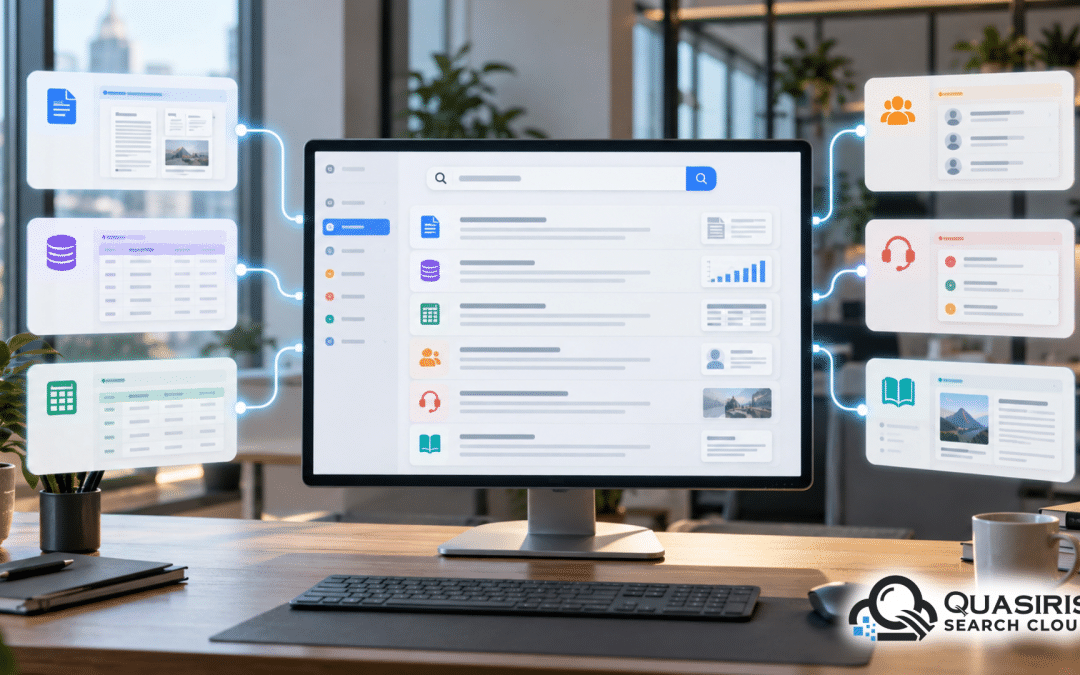
In der Reihe „Inside AI Search“ zeigt Quasiris, was hinter den einzelnen Funktionen moderner KI gestützter Suche steckt. In diesem Beitrag geht es um Federated Search, also die Möglichkeit, mehrere Datenquellen und Repositories über eine gemeinsame Suche gleichzeitig zu erschließen.
Denn Unternehmenswissen liegt selten an einem einzigen Ort. Informationen verteilen sich auf Wikis, Dokumentenmanagementsysteme, Datenbanken, Produktplattformen, CRM Systeme, Suchindizes und weitere Fachanwendungen.
Für Nutzer entsteht dadurch ein bekanntes Problem: Sie müssen zunächst wissen, wo eine Information gespeichert ist, bevor sie überhaupt danach suchen können.
Federated Search dreht dieses Prinzip um.
Der Nutzer stellt eine Anfrage. Das System kümmert sich darum, welche Quellen dafür relevant sind.
Was ist Federated Search?
Federated Search bezeichnet eine Sucharchitektur, bei der mehrere voneinander getrennte Datenquellen oder Suchsysteme über eine gemeinsame Anfrage durchsucht werden.
Statt jede Quelle einzeln zu öffnen, stellt der Nutzer seine Anfrage über eine zentrale Oberfläche.
Vereinfacht läuft der Prozess so ab:
- Eine Suchanfrage wird gestellt.
- Das System bestimmt geeignete Datenquellen.
- Die Anfrage wird an diese Quellen weitergeleitet.
- Jede Quelle liefert passende Ergebnisse zurück.
- Die Ergebnisse werden bewertet und zusammengeführt.
- Der Nutzer erhält eine gemeinsame Trefferliste oder eine darauf basierende Antwort.
Dabei müssen die Daten nicht zwangsläufig vollständig in einen gemeinsamen Index übertragen werden.
Das unterscheidet Federated Search von einer rein zentralisierten Enterprise Search Architektur.
Ein Suchfeld statt vieler Systeme
Ein Beispiel aus dem Kundenservice zeigt den Nutzen.
Ein Mitarbeiter möchte wissen:
„Welche bekannten Probleme gibt es bei Produkt X und wie können wir sie lösen?“
Die notwendigen Informationen können über verschiedene Systeme verteilt sein:
• Produktinformationen im PIM
• technische Anleitungen im Wiki
• bekannte Fehler in einer Supportdatenbank
• frühere Kundenfälle im Ticketsystem
• Servicehinweise in einer Dokumentenplattform
Ohne übergreifende Suche müsste der Mitarbeiter mehrere Systeme nacheinander öffnen und dieselbe Frage unterschiedlich formulieren.
Federated Search ermöglicht einen zentralen Zugang.
Der Nutzer muss nicht mehr wissen, in welchem System die Antwort gespeichert ist. Entscheidend ist nur noch die eigentliche Informationsfrage.
Zentraler Index oder Federated Search?
Beide Ansätze haben ihre Berechtigung.
Bei einer zentralen Suche werden Inhalte aus verschiedenen Quellen übernommen und in einem gemeinsamen Suchindex gespeichert.
Das kann Vorteile bei Geschwindigkeit, einheitlichem Ranking und Analyse bieten.
Bei Federated Search bleiben die Daten dagegen stärker in ihren jeweiligen Systemen. Die einzelnen Quellen werden zum Zeitpunkt der Suche angesprochen oder über bestehende Suchschnittstellen eingebunden.
Das kann sinnvoll sein, wenn:
• Daten sehr häufig aktualisiert werden
• bestehende Suchsysteme weiter genutzt werden sollen
• Inhalte nicht vollständig kopiert werden dürfen
• verschiedene Abteilungen ihre Systeme unabhängig verwalten
• große Datenmengen nicht erneut indexiert werden sollen
• unterschiedliche Zugriffsmodelle bestehen
In der Praxis müssen sich beide Modelle nicht ausschließen.
Ein Unternehmen kann einen Teil seiner Informationen zentral indexieren und andere Quellen föderiert anbinden.
Nicht jede Anfrage muss an jede Quelle gehen
Eine einfache Umsetzung von Federated Search könnte jede Anfrage gleichzeitig an sämtliche angebundenen Systeme senden.
Das ist jedoch nicht immer effizient.
Sucht ein Mitarbeiter beispielsweise nach einer Reisekostenrichtlinie, muss nicht gleichzeitig ein technisches Ersatzteilsystem durchsucht werden.
Moderne Federated Search Architekturen können deshalb zunächst entscheiden, welche Quellen für die Anfrage wahrscheinlich relevant sind.
Ein Forschungsansatz für federiertes RAG zeigt, wie groß dieser Unterschied sein kann. Das dort entwickelte Routingverfahren wählt zur Laufzeit gezielt relevante Wissensquellen aus, statt jede Quelle abzufragen. In den untersuchten Benchmarks ließ sich dadurch die Zahl der Suchanfragen um bis zu 77,5 Prozent und das übertragene Datenvolumen um bis zu 76,2 Prozent reduzieren.¹
Das verdeutlicht einen wichtigen Punkt:
Eine gute Federated Search durchsucht nicht möglichst viele Systeme, sondern möglichst gezielt die richtigen.
Die eigentliche Herausforderung beginnt beim Zusammenführen
Mehrere Systeme parallel zu durchsuchen ist nur ein Teil der Aufgabe.
Schwieriger ist die Frage:
Welches Ergebnis sollte am Ende an erster Stelle stehen?
Jede Quelle kann ihr eigenes Ranking verwenden.
Ein CRM bewertet Suchergebnisse möglicherweise nach anderen Kriterien als ein Wiki oder eine technische Dokumentensuche.
Auch die gelieferten Relevanzwerte sind häufig nicht direkt vergleichbar.
Federated Search benötigt deshalb eine zusätzliche Ebene, die Ergebnisse harmonisiert und gemeinsam bewertet.
Dabei können unter anderem berücksichtigt werden:
• Relevanz zur Anfrage
• Quelle und Dokumenttyp
• Aktualität
• fachliche Autorität
• Berechtigungen
• Metadaten
• Dubletten
• Nutzerkontext
Ohne diese Zusammenführung würde Federated Search lediglich mehrere Trefferlisten nebeneinanderstellen.
Das Ziel ist jedoch eine gemeinsame, nachvollziehbare Ergebnisstruktur.
Heterogene Quellen erschweren das Retrieval
Nicht nur das Ranking unterscheidet sich zwischen Datenquellen.
Auch Sprache, Aufbau und Informationsstruktur können stark variieren.
Ein technisches Handbuch enthält andere Begriffe als ein Supportticket. Ein Produktkatalog ist anders aufgebaut als ein Unternehmenswiki.
Gerade bei komplexen oder mehrdeutigen Fragen muss ein System deshalb erkennen, welche Wissensdomäne besonders relevant ist.
Wie wichtig diese Zuordnung ist, zeigt ein 2026 vorgestelltes Verfahren für Federated Retrieval. In Tests über fünf Benchmarks verbesserte der Ansatz die Klassifikation der richtigen Wissensquelle gegenüber bestehenden Verfahren um bis zu 14,37 Prozent, den Retrieval Recall um bis zu 5,38 Prozent und die nachgelagerte Question Answering Qualität um bis zu 6,45 Prozent.²
Die Quelle einer Information wird damit selbst zu einem wichtigen Bestandteil der Suchentscheidung.
Warum Federated Search für RAG und AI Agents relevanter wird
Bei einer klassischen Enterprise Search entscheidet ein Mensch, welche gefundenen Dokumente er öffnet.
Bei RAG und AI Agents übernimmt ein System einen größeren Teil dieses Prozesses.
Ein Sprachmodell oder Agent muss dafür auf das relevante Unternehmenswissen zugreifen können.
Wenn dieses Wissen über mehrere Systeme verteilt ist, reicht ein einzelner Vector Store oder Dokumentenindex häufig nicht aus.
Federated Search kann hier als Retrievalschicht dienen.
Ein AI Agent könnte beispielsweise erkennen:
Für Produktinformationen benötige ich das PIM.
Für technische Details benötige ich die Dokumentation.
Für den aktuellen Kundenstatus benötige ich das CRM.
Anschließend lassen sich Informationen aus mehreren Quellen für eine Antwort oder einen Workflow kombinieren.
Eine systematische Untersuchung von Federated RAG nennt gerade den Umgang mit verteilten Daten, unterschiedlichen Systemen und Datenschutzanforderungen als zentrale Herausforderungen solcher Architekturen.³
Federated Search wird damit zu einem Baustein für KI Systeme, die nicht nur auf einen einzelnen Informationsbestand zugreifen sollen.
Berechtigungen müssen quellenübergreifend funktionieren
- Ein zentraler Suchzugang darf nicht bedeuten, dass bestehende Zugriffsrechte verschwinden.
- Verschiedene Unternehmenssysteme verwenden häufig unterschiedliche Berechtigungsmodelle.
- Ein Dokumentenmanagementsystem kann Rechte auf Ordner vergeben.
- Ein CRM arbeitet möglicherweise mit Kundenzuständigkeiten.
- Ein Wiki kann Inhalte anhand von Gruppen freigeben.
- Eine Federated Search muss diese Grenzen berücksichtigen.
- Ein Ergebnis darf nicht allein deshalb sichtbar sein, weil das zentrale Suchsystem technisch auf die Quelle zugreifen kann.
Besonders wichtig wird das bei generierten Antworten. Wenn ein Sprachmodell aus mehreren Dokumenten eine Antwort erstellt, dürfen nur Inhalte verwendet werden, auf die der jeweilige Nutzer tatsächlich zugreifen darf.
Berechtigungen müssen deshalb bereits beim Retrieval greifen und nicht erst bei der Anzeige des Ergebnisses.
Aktualität ist ein wichtiger Vorteil
Eine Herausforderung zentraler Indizes ist die Synchronisation.
Wird ein Dokument im Quellsystem geändert, muss diese Änderung zunächst in den Suchindex übertragen werden.
Abhängig von Infrastruktur und Aktualisierungsintervall kann dadurch eine zeitliche Verzögerung entstehen.
Bei föderierten Abfragen können bestimmte Informationen dagegen direkt aus dem aktuellen Quellsystem stammen.
Das kann insbesondere relevant sein bei:
• Beständen
• Preisen
• Supportfällen
• Systemstatus
• Kundendaten
• häufig aktualisierten Dokumentationen
Federated Search ist deshalb besonders interessant, wenn Aktualität eine zentrale Rolle spielt.
Das bedeutet jedoch nicht, dass jede Information live abgefragt werden sollte. Für wenig veränderliche Dokumente kann ein zentraler Index weiterhin effizienter sein.
Geschwindigkeit bleibt eine Herausforderung
Mehrere Datenquellen bedeuten auch mehrere potenzielle Antwortzeiten.
Wenn fünf Systeme schnell reagieren und eine Quelle deutlich langsamer ist, muss die Sucharchitektur entscheiden, wie damit umgegangen wird.
Mögliche Strategien sind:
• nur relevante Quellen abfragen
• Quellen parallel durchsuchen
• Zeitlimits definieren
• erste Ergebnisse vorab anzeigen
• langsamere Quellen nachladen
• häufig verwendete Informationen zwischenspeichern
Damit wird Federated Search auch zu einer Frage intelligenter Orchestrierung.
Ein gutes System muss nicht nur relevante Informationen finden, sondern dies in einer Geschwindigkeit tun, die für Nutzer akzeptabel bleibt.
Federated Search bedeutet nicht automatisch Datenzentralisierung
Ein wichtiger Vorteil föderierter Architekturen besteht darin, dass vorhandene Systeme nicht zwangsläufig ersetzt werden müssen.
Bestehende Suchmaschinen, Datenbanken und Wissensplattformen können weiterhin ihre jeweilige Aufgabe erfüllen.
Federated Search schafft darüber eine gemeinsame Zugriffsebene.
Gerade für Unternehmen mit gewachsenen IT Landschaften kann das eine Alternative zu großen Migrationsprojekten sein.
Dabei gilt jedoch:
Weniger Datenbewegung bedeutet nicht automatisch weniger Komplexität.
Die Herausforderung verschiebt sich zu Themen wie Schnittstellen, Ranking, Berechtigungen, Ausfallsicherheit und Governance.
Wo Federated Search besonders sinnvoll ist
Enterprise Search
Mitarbeitende erhalten einen gemeinsamen Zugang zu Wissen aus unterschiedlichen Abteilungen und Systemen.
Kundenservice
Produktinformationen, Supportfälle und Dokumentationen können über eine Anfrage zusammengeführt werden.
Technischer Support
Handbücher, Fehlerdatenbanken und Serviceinformationen lassen sich gemeinsam durchsuchen.
RAG und Question Answering
Ein Sprachmodell erhält relevante Informationen aus mehreren Wissensquellen statt aus einem einzigen Index.
AI Agents
Agenten können abhängig von ihrer Aufgabe unterschiedliche Unternehmenssysteme gezielt als Wissensquelle nutzen.
E Commerce
Produktinformationen, Verfügbarkeiten, Beratungsinhalte und weitere Daten können aus unterschiedlichen Systemen zusammengeführt werden.
Wann ein zentraler Index trotzdem die bessere Wahl sein kann
Federated Search ist keine Universallösung.
Wenn alle relevanten Inhalte problemlos zentralisiert werden können, einheitliche Berechtigungen besitzen und sich nur selten verändern, kann ein gemeinsamer Index einfacher und schneller sein. Federated Search lohnt sich vor allem dort, wo die Verteilung der Daten einen konkreten Grund hat.
Unternehmen sollten deshalb nicht mit der Frage starten:
„Wie können wir alle Systeme föderiert durchsuchen?“
Sondern:
„Welche Informationen sollten zentral indexiert werden und welche müssen oder sollten in ihren bestehenden Quellen verbleiben?“
Die Antwort kann für jede Datenquelle unterschiedlich ausfallen.
Fazit: Eine Suche muss nicht bedeuten, dass alle Daten an einem Ort liegen
Unternehmenswissen ist verteilt. Eine moderne Search Experience sollte diese organisatorische und technische Realität berücksichtigen.
Federated Search ermöglicht es, mehrere Datenquellen über einen gemeinsamen Zugang zu durchsuchen und ihre Ergebnisse zusammenzuführen.
Der eigentliche Mehrwert entsteht jedoch nicht allein durch die Verbindung der Systeme.
Entscheidend sind intelligentes Source Routing, ein gemeinsames Ranking, korrekte Berechtigungen und eine Architektur, die mit unterschiedlichen Antwortzeiten und Datenstrukturen umgehen kann.
Besonders im Zusammenspiel mit RAG und AI Agents gewinnt diese Fähigkeit an Bedeutung. Denn KI Anwendungen benötigen einen kontrollierten Zugang zu genau den Informationen, die für eine konkrete Aufgabe relevant sind.
Federated Search macht aus verteiltem Wissen einen gemeinsamen Informationszugang, ohne zwangsläufig alle Daten in ein einziges System verschieben zu müssen.
Die Quasiris Search Cloud unterstützt Federated Search und ermöglicht es, unterschiedliche Datenquellen und Repositories über eine gemeinsame Search Experience zugänglich zu machen.
Sie möchten Ihre bestehenden Wissensquellen und Suchsysteme miteinander verbinden? Sprechen Sie mit den Search Experten von Quasiris über Ihre Datenlandschaft und Ihren Anwendungsfall.
💡 Wie gut ist Ihre Suche wirklich?
Unpassende Treffer, hohe Nulltrefferquoten und aufwendige manuelle Rankingregeln sind häufig ein Hinweis darauf, dass eine Suche ihr Potenzial noch nicht vollständig ausschöpft.
Mit unserem kostenlosen Search Review erhalten Sie eine erste Einschätzung zur Qualität Ihrer bestehenden Suche und zu möglichen Optimierungspotenzialen.
↓ Jetzt kostenloses Search Review anfragen ↓
Quellen
¹ Guerraoui, R., Kermarrec, A. M., Petrescu, D., Pires, R., Randl, M., & de Vos, M. (2025). Efficient federated search for retrieval-augmented generation. In Proceedings of the 5th Workshop on Machine Learning and Systems. Association for Computing Machinery.
https://doi.org/10.1145/3721146.3721942
² Yang, Z., Jiang, X., Qiu, R., Li, R., Zhang, Y., Fang, Y., Xu, Y., Ding, H., Chu, X., Zhao, J., & Wang, Y. (2026). DFAMS: Dynamic-flow guided federated alignment based multi-prototype search. In Proceedings of the 64th Annual Meeting of the Association for Computational Linguistics (pp. 24728–24752). Association for Computational Linguistics.
https://doi.org/10.18653/v1/2026.acl-long.1135
³ Chakraborty, A., Dahal, C., & Gupta, V. (2025). Federated retrieval-augmented generation: A systematic mapping study. In Findings of the Association for Computational Linguistics: EMNLP 2025 (pp. 7362–7374). Association for Computational Linguistics.
https://doi.org/10.18653/v1/2025.findings-emnlp.388