In der Reihe „Inside AI Search“ zeigt Quasiris, was hinter den einzelnen Funktionen moderner KI gestützter Suche steckt. In diesem Beitrag geht es um Automatic Re Ranking, also die automatische Neubewertung bereits gefundener Suchergebnisse.
Denn eine Suchmaschine kann relevante Inhalte finden und trotzdem keine gute Suche liefern.
Wenn die wichtigste Information erst weit unten in der Trefferliste erscheint, ist sie für Nutzer nur schwer auffindbar. Gute Suchqualität hängt deshalb nicht nur davon ab, was gefunden wird, sondern auch davon, in welcher Reihenfolge die Ergebnisse erscheinen.
Was ist Automatic Re Ranking?
Viele Suchsysteme arbeiten in mehreren Stufen.
Im ersten Schritt durchsucht das Retrieval einen großen Datenbestand und ermittelt eine begrenzte Menge möglicher Treffer. Dafür können beispielsweise Keyword Search, Vektorsuche oder Hybrid Search eingesetzt werden.
Im zweiten Schritt bewertet ein Re Ranking Modell diese Kandidaten noch einmal genauer.
Vereinfacht gesagt:
Retrieval entscheidet, welche Inhalte grundsätzlich infrage kommen.
Re Ranking entscheidet, welche davon für die konkrete Anfrage am relevantesten sind.
Dieser zweite Schritt kann detaillierter arbeiten, weil nicht mehr Millionen von Dokumenten verglichen werden müssen, sondern nur eine kleinere Auswahl.
Warum reicht das ursprüngliche Ranking nicht immer aus?
Die erste Retrievalstufe muss vor allem schnell sein. Sie soll aus einem großen Datenbestand möglichst zuverlässig relevante Kandidaten identifizieren.
Dabei können jedoch Feinheiten verloren gehen.
Ein Beispiel:
Ein Mitarbeiter sucht nach:
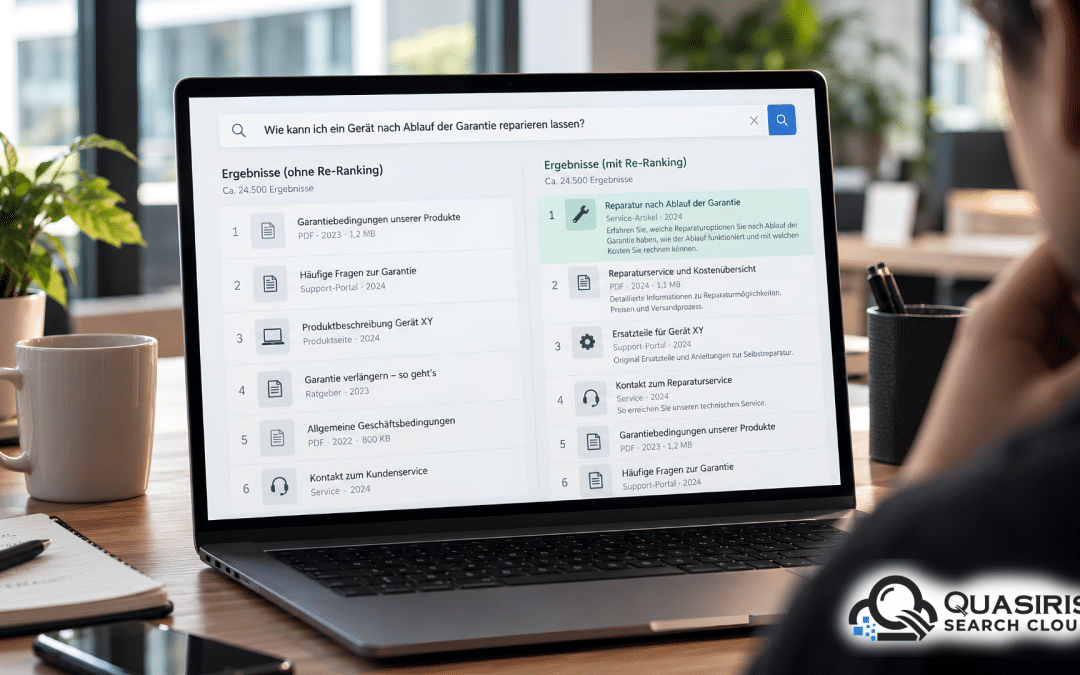
„Wie kann ich ein Gerät nach Ablauf der Garantie reparieren lassen?“
Ein Dokument mit vielen Vorkommen des Begriffs „Garantie“ kann im ursprünglichen Ranking weit oben erscheinen.
Ein anderer Serviceartikel beschreibt dagegen konkret den Ablauf kostenpflichtiger Reparaturen nach Ende der Garantie. Obwohl dort möglicherweise weniger identische Begriffe vorkommen, beantwortet dieser Inhalt die tatsächliche Frage besser.
Automatic Re Ranking kann solche Unterschiede erkennen und die Reihenfolge entsprechend anpassen.
Welche Signale können berücksichtigt werden?
Die genaue Konfiguration hängt vom jeweiligen Anwendungsfall ab. Ein Re Ranking Modell kann unter anderem folgende Faktoren berücksichtigen:
• inhaltliche Übereinstimmung mit der gesamten Anfrage
• semantischen Kontext
• Dokumenttyp
• Aktualität
• Metadaten
• definierte Geschäftsregeln
• Interaktionssignale
• Nutzerkontext
• Eignung eines Dokuments für eine nachgelagerte Antwortgenerierung
Dadurch entsteht ein differenzierteres Ranking als bei einem einfachen Abgleich einzelner Begriffe.
Relevanz ist mehr als thematische Ähnlichkeit
Ein Dokument kann thematisch zur Anfrage passen und trotzdem wenig hilfreich sein.
Genau dieser Unterschied wird mit generativer KI noch wichtiger.
Für ein RAG System ist nicht nur relevant, ob ein Dokument das gleiche Thema behandelt. Entscheidend ist auch, ob es die Informationen enthält, die ein Sprachmodell für eine korrekte Antwort benötigt.
Klassische Re Ranking Modelle werden häufig anhand von Relevanzbewertungen optimiert. Ein Dokument kann dabei als relevant gelten, obwohl es dem nachgelagerten Sprachmodell nicht ausreichend dabei hilft, eine richtige Antwort zu erzeugen. Ein 2026 vorgestellter Ansatz optimiert das Re Ranking deshalb direkt anhand des Nutzens für die spätere Antwortgenerierung und konnte damit starke bestehende Reranker in wissensintensiven Benchmarks übertreffen.³
Damit verändert sich die Frage von:
„Passt dieses Dokument thematisch zur Anfrage?“
zu:
„Hilft dieses Dokument tatsächlich dabei, die Aufgabe korrekt zu lösen?“
Warum Re Ranking für RAG besonders wichtig ist
Bei einer klassischen Suche sehen Nutzer mehrere Ergebnisse und können selbst entscheiden, welches Dokument sie öffnen möchten.
Bei Retrieval Augmented Generation trifft das System einen Teil dieser Entscheidung bereits automatisch.
Nur eine begrenzte Zahl von Dokumenten wird als Kontext an das Sprachmodell übergeben. Was dort nicht enthalten ist, kann für die Antwort fehlen.
Umgekehrt können irrelevante oder ablenkende Inhalte die Antwortqualität verschlechtern.
Aktuelle Ansätze zur Bewertung von Retrievalsystemen zeigen deshalb, dass traditionelle Rankingmetriken für RAG nur einen Teil der tatsächlichen Qualität erfassen. Neben der Relevanz eines Dokuments spielt auch dessen konkreter Nutzen für die spätere Antwort eine Rolle.²
Re Ranking übernimmt damit eine wichtige Filterfunktion zwischen Retrieval und Sprachmodell.
Automatic Re Ranking muss schnell bleiben
Ein möglichst präzises Modell wäre wenig hilfreich, wenn Nutzer mehrere Sekunden auf jede Ergebnisliste warten müssten.
Automatic Re Ranking ist deshalb immer auch ein Kompromiss zwischen Qualität und Rechenaufwand.
In der Praxis bietet sich häufig eine mehrstufige Architektur an:
Stufe 1: Ein schnelles Retrieval findet beispielsweise die 100 wahrscheinlich relevantesten Ergebnisse.
Stufe 2: Ein genaueres Re Ranking Modell bewertet diese Kandidaten.
Stufe 3: Nur die besten Ergebnisse werden angezeigt oder für eine KI Antwort verwendet.
So muss das aufwendigere Modell nur mit einer kleinen Ergebnismenge arbeiten.
Das macht Re Ranking auch für große Dokumentbestände und Produktkataloge praktikabel.
Nicht jeder Reranker bewertet Informationen gleich gut
Eine weitere Herausforderung entsteht durch unterschiedliche Dokumentstile.
Unternehmenswissen besteht selten aus einheitlich aufgebauten Texten. Ein Suchindex kann technische Handbücher, Supportartikel, kurze FAQs, Verträge, Produkttexte und interne Notizen enthalten.
Dabei darf ein Rankingmodell einen sprachlich gut formulierten Text nicht automatisch einem fachlich besseren Dokument vorziehen.
Eine Untersuchung aus dem Jahr 2026 zeigt, dass Reranker tatsächlich durch unterschiedliche Schreibstile beeinflusst werden können. Ein speziell darauf ausgerichtetes Verfahren reduzierte diesen Einfluss und verbesserte gleichzeitig die Qualität der nachgelagerten Antwortgenerierung über mehrere Sprachmodelle hinweg.¹
Für Unternehmen ist das besonders relevant, weil ihre Informationsbestände meist aus sehr unterschiedlichen Quellen stammen.
Geschäftsregeln bleiben wichtig
Automatic Re Ranking bedeutet nicht, dass sämtliche Entscheidungen einem Modell überlassen werden sollten.
Es gibt Anforderungen, die unabhängig von einer errechneten Relevanz gelten müssen.
Beispiele:
Aktuelle Richtlinien sollten veraltete Versionen überstimmen.
Nicht verfügbare Produkte dürfen gegebenenfalls nicht prominent angezeigt werden.
Dokumente ohne passende Berechtigung dürfen überhaupt nicht in das Ranking gelangen.
Bestimmte Sicherheitsinformationen können eine feste Priorität erhalten.
Eine robuste Sucharchitektur verbindet deshalb lernende Relevanzmodelle mit klaren fachlichen Regeln.
Die KI optimiert innerhalb eines definierten Rahmens.
Klicks sind hilfreich, aber nicht automatisch objektiv
Interaktionsdaten können zusätzliche Hinweise für das Ranking liefern.
Wenn ein bestimmtes Ergebnis bei einer Anfrage häufig ausgewählt wird, kann das auf hohe Relevanz hinweisen.
Allerdings beeinflusst die bestehende Reihenfolge selbst das Verhalten. Ergebnisse auf den oberen Positionen werden häufiger gesehen und angeklickt.
Automatic Re Ranking sollte deshalb nicht ausschließlich auf rohe Klickzahlen reagieren.
Sinnvoller ist die Verbindung verschiedener Signale:
• fachlich bewertete Suchanfragen
• Interaktionsdaten
• Dokumentmerkmale
• Kontextsignale
• Geschäftsregeln
• definierte Qualitätsmetriken
Damit reduziert sich das Risiko, dass sich bestehende Rankingfehler selbst verstärken.
Wo Automatic Re Ranking besonders sinnvoll ist
Die Funktion kann in sehr unterschiedlichen Search Szenarien eingesetzt werden.
E Commerce
Produkte werden nicht nur nach Keyword Übereinstimmung, sondern auch nach Kontext, Verfügbarkeit und relevanten Eigenschaften sortiert.
Enterprise Search
Bei großen Dokumentbeständen können aktuelle und fachlich passende Inhalte gegenüber oberflächlich ähnlichen Dokumenten priorisiert werden.
Wissensmanagement
Richtlinien, Handbücher und interne Dokumentationen werden anhand der tatsächlichen Informationsabsicht neu bewertet.
RAG und Question Answering
Nur die Inhalte mit dem größten Nutzen für die Beantwortung einer Frage werden an das Sprachmodell übergeben.
Kundenservice
Serviceartikel können abhängig von Problem, Produkt und aktuellem Kontext priorisiert werden.
Wie lässt sich Rankingqualität messen?
Eine Suchmaschine sollte nicht allein danach beurteilt werden, ob sie irgendeinen passenden Treffer findet.
Entscheidend ist, wie früh relevante Inhalte erscheinen.
Dafür können verschiedene Metriken verwendet werden.
Precision untersucht, wie viele der angezeigten Ergebnisse tatsächlich relevant sind.
Recall betrachtet, wie viele der vorhandenen relevanten Inhalte überhaupt gefunden wurden.
Mean Reciprocal Rank bewertet insbesondere die Position des ersten relevanten Ergebnisses.
nDCG berücksichtigt die Relevanz über mehrere Positionen hinweg und gewichtet Ergebnisse weiter oben stärker.
Für Unternehmen ist zusätzlich ein eigener Goldstandard hilfreich.
Dafür werden repräsentative Suchanfragen definiert und gemeinsam mit Fachexperten festgelegt, welche Ergebnisse für diese Anfragen besonders relevant sind.
Anschließend lässt sich prüfen, ob eine neue Rankingkonfiguration tatsächlich bessere Ergebnisse liefert.
Fazit: Gefunden reicht nicht
Suchqualität endet nicht beim Retrieval.
Eine Suchmaschine kann alle relevanten Inhalte finden und Nutzer trotzdem enttäuschen, wenn die besten Ergebnisse an den falschen Positionen erscheinen.
Automatic Re Ranking ergänzt deshalb das erste Retrieval um eine genauere Bewertung der Treffer. Dabei können semantischer Kontext, Metadaten, Aktualität, Geschäftslogik und weitere Signale zusammengeführt werden.
Besonders im Zusammenspiel mit RAG gewinnt diese zweite Bewertungsstufe an Bedeutung. Denn dort entscheidet das Ranking nicht nur darüber, was Nutzer sehen, sondern auch darüber, welches Wissen ein Sprachmodell für seine Antwort erhält.
Die zentrale Aufgabe lautet deshalb:
Nicht möglichst viele Treffer finden, sondern die hilfreichsten Informationen zuverlässig nach vorne bringen.
Die Quasiris Search Cloud unterstützt Automatic Re Ranking und ermöglicht es, Suchergebnisse anhand von Relevanz, Kontext und weiteren Signalen automatisch neu zu bewerten.
Sie möchten herausfinden, ob die relevantesten Inhalte Ihrer Suche bereits auf den richtigen Positionen erscheinen? Sprechen Sie mit den Search Experten von Quasiris über Ihren Anwendungsfall.
💡 Wie gut ist Ihre Suche wirklich?
Unpassende Treffer, hohe Nulltrefferquoten und aufwendige manuelle Rankingregeln sind häufig ein Hinweis darauf, dass eine Suche ihr Potenzial noch nicht vollständig ausschöpft.
Mit unserem kostenlosen Search Review erhalten Sie eine erste Einschätzung zur Qualität Ihrer bestehenden Suche und zu möglichen Optimierungspotenzialen.
↓ Jetzt kostenloses Search Review anfragen ↓
Quellen
¹ Zhang, R., Liu, B., Xiang, Z. S., Chen, Y., Zhao, H., Ding, D., Jin, J., & Cao, J. (2026). Don’t be misled by style: A style adaptive reranker for capturing effective knowledge in retrieval augmented generation. In Proceedings of the 64th Annual Meeting of the Association for Computational Linguistics (pp. 6665–6681). Association for Computational Linguistics.
https://doi.org/10.18653/v1/2026.acl-long.302
² Trappolini, G., Cuconasu, F., Filice, S., Maarek, Y., & Silvestri, F. (2026). Redefining retrieval evaluation in the era of LLMs. In Proceedings of the 19th Conference of the European Chapter of the Association for Computational Linguistics. Association for Computational Linguistics.
https://aclanthology.org/2026.eacl-long.391/
³ Wu, Y., Shen, X., Wang, F., Zhou, C., Wu, Z., Dai, X., & Xia, R. (2026). Optimizing RAG rerankers with LLM feedback via reinforcement learning. In Proceedings of the 64th Annual Meeting of the Association for Computational Linguistics (pp. 30474–30490). Association for Computational Linguistics.
https://doi.org/10.18653/v1/2026.acl-long.1406