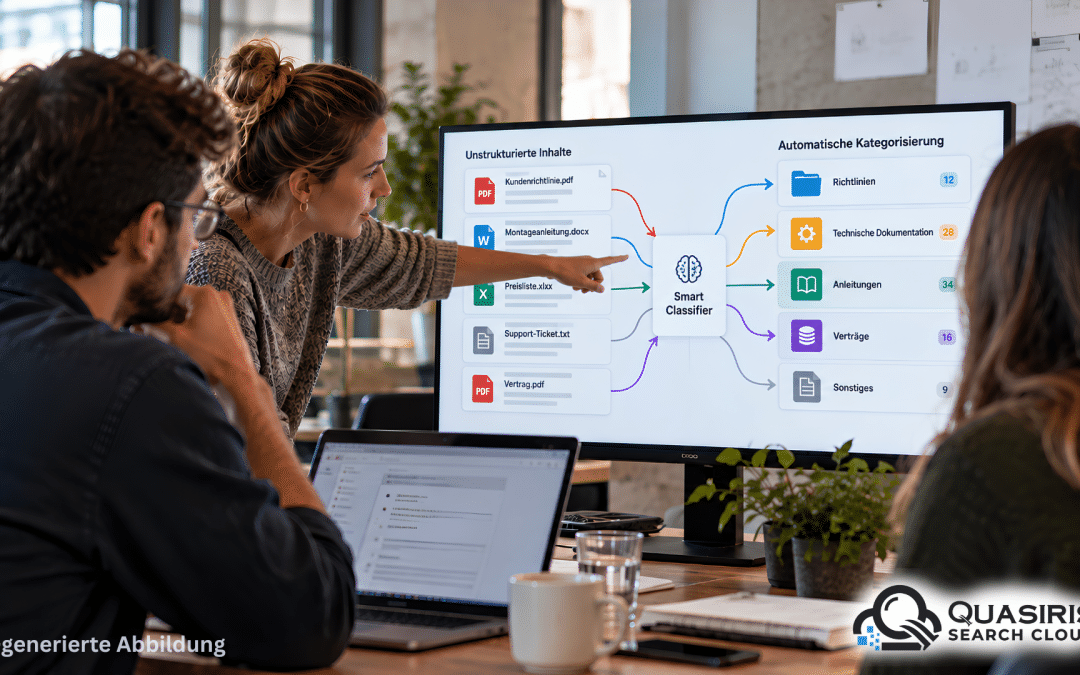
In der Reihe „Inside AI Search“ zeigt Quasiris, was hinter den einzelnen Funktionen moderner KI gestützter Suche steckt. In diesem Beitrag geht es um Smart Classifier, also die automatische Klassifikation und Kategorisierung von Dokumenten, Produkten oder anderen Inhalten mithilfe von Machine Learning.
Denn gute Suche beginnt nicht erst mit der Suchanfrage.
Damit ein Suchsystem relevante Inhalte finden, filtern und priorisieren kann, muss es zunächst verstehen, worum es in diesen Inhalten geht.
Genau hier setzt ein Smart Classifier an.
Er kann beispielsweise erkennen, ob ein Dokument eine Rechnung, eine technische Anleitung oder eine Richtlinie ist. Er kann Produkttexte einer Kategorie zuordnen oder Inhalte automatisch mit Themen und Merkmalen versehen.
Aus unstrukturierten Informationen entstehen so zusätzliche Strukturen, die später für Suche, Filterung, Routing und weitere KI Funktionen genutzt werden können.
Was ist ein Smart Classifier?
Ein Classifier erhält einen Inhalt und ordnet ihm eine oder mehrere vordefinierte Klassen zu.
Ein Supportdokument könnte beispielsweise den Kategorien
• Installation
• Fehlerbehebung
• Wartung
• Garantie
zugeordnet werden.
Bei einer Unternehmenssuche könnten Klassen wie
• Personal
• IT
• Datenschutz
• Einkauf
• Finanzen
relevant sein.
Der Begriff Smart Classifier beschreibt dabei nicht ein einzelnes Modell, sondern eine intelligente Klassifikationskomponente, die je nach Anwendungsfall unterschiedliche Machine Learning Verfahren einsetzen kann.
Dazu zählen unter anderem klassische Machine Learning Modelle, neuronale Textmodelle, Encoder Modelle wie BERT oder auch Large Language Models.
Warum Klassifikation für Search wichtig ist
Eine Suchmaschine kann auch ohne automatische Klassifikation funktionieren.
Je komplexer die Datenlandschaft wird, desto wertvoller werden jedoch zusätzliche Informationen über die Inhalte.
Ein Dokument enthält beispielsweise den Satz:
„Beschädigte Geräte können innerhalb von 24 Monaten über den Serviceprozess eingeschickt werden.“
Ein Smart Classifier könnte daraus zusätzliche Kategorien ableiten:
Dokumenttyp: Serviceinformation
Thema: Reparatur
Produktbereich: Hardware
Prozess: Reklamation
Lebenszyklus: After Sales
Diese Informationen stehen möglicherweise nicht explizit als Metadaten im Dokument.
Nach der Klassifikation können sie trotzdem für die Suche genutzt werden.
Dadurch lassen sich beispielsweise Filter erzeugen, Datenquellen gezielter durchsuchen oder bestimmte Inhalte beim Ranking stärker berücksichtigen.
Ein Inhalt kann mehreren Kategorien gleichzeitig angehören
Klassifikation bedeutet nicht zwangsläufig, dass jedes Dokument genau eine Kategorie erhält.
In Unternehmensdaten ist häufig das Gegenteil der Fall.
Eine Richtlinie zur Nutzung privater Smartphones im Unternehmen kann gleichzeitig relevant sein für:
• IT Sicherheit
• Datenschutz
• Mobile Devices
• Personalrichtlinien
Hier spricht man von Multi Label Classification.
Noch komplexer wird es, wenn Kategorien hierarchisch organisiert sind.
Zum Beispiel:
Technik
→ Hardware
→ Mobile Devices
→ Smartphones
Ein Classifier muss dann nicht nur die passende Kategorie finden, sondern auch die Struktur der Taxonomie berücksichtigen.
Aktuelle Forschung zeigt, dass genau diese hierarchische Information die Klassifikation verbessern kann. HYDRA behandelt jede Ebene einer Taxonomie als eigene Klassifikationsaufgabe und erreichte in vier untersuchten Benchmarks durchgehend bessere Ergebnisse als vergleichbare flache Modelle. Gleichzeitig konnte der Ansatz mit deutlich komplexeren Verfahren mithalten oder diese übertreffen.¹
Warum Hierarchien mehr sind als Ordnerstrukturen
Hierarchische Kategorien enthalten Beziehungen.
Wenn ein Dokument als Notebook klassifiziert wird, gehört es in der Regel auch zu Computer, Hardware und möglicherweise IT Ausstattung.
Diese Beziehungen lassen sich für die Suche nutzen.
Ein Nutzer, der nach Hardware sucht, kann dadurch auch Inhalte finden, die auf einer tieferen Ebene als Notebook oder Monitor klassifiziert wurden.
Eine solche Struktur ist besonders hilfreich bei:
• großen Produktkatalogen
• Wissensdatenbanken
• wissenschaftlichen Dokumenten
• technischen Dokumentationen
• Supportinhalten
• umfangreichen Intranets
Die Herausforderung besteht darin, die Taxonomie sinnvoll abzubilden.
Eine sehr detaillierte Kategorisierung ist nicht automatisch besser. Wenn Kategorien kaum voneinander unterscheidbar sind oder sich stark überschneiden, steigt auch das Risiko von Fehlklassifikationen.
Klassifikation kann fehlende Metadaten ergänzen
Viele Unternehmen besitzen große Dokumentbestände, deren Metadaten unvollständig oder uneinheitlich sind.
Ein Teil der Dateien wurde möglicherweise manuell kategorisiert, andere besitzen nur Dateinamen und Erstellungsdatum.
Smart Classification kann hier zusätzliche Informationen erzeugen.
Zum Beispiel:
Ausgangsdokument:
„Montageanleitung Modell X500“
Automatisch erkannte Merkmale:
Dokumenttyp: Anleitung
Produkt: X500
Thema: Montage
Zielgruppe: Technischer Service
Sprache: Deutsch
Diese Metadaten können anschließend in den Suchindex übernommen werden.
Damit verbessert der Classifier nicht unmittelbar das Ranking, sondern zunächst die Informationsbasis, auf der die Suche arbeitet.
Das ist ein wichtiger Unterschied.
Smart Classifier und Semantic Search erfüllen unterschiedliche Aufgaben
Beide Verfahren arbeiten mit der Bedeutung von Texten, verfolgen aber unterschiedliche Ziele.
Semantic Search fragt:
Welche Inhalte passen inhaltlich zu dieser Suchanfrage?
Ein Smart Classifier fragt dagegen:
Zu welcher Kategorie oder Klasse gehört dieser Inhalt?
Ein Dokument über Reisekosten könnte semantisch zu einer Frage nach Hotelpauschalen passen.
Der Classifier könnte dasselbe Dokument zusätzlich als
Finanzen → Reisekosten → Hotel
kategorisieren.
Die Klassifikation erzeugt damit strukturierte Merkmale, die später von der Suche genutzt werden können.
Ein Classifier muss nicht auf einem Large Language Model basieren
Auch bei Smart Classification gilt: Nicht jede KI Aufgabe benötigt ein Large Language Model.
Wenn ein Unternehmen klar definierte Kategorien und ausreichend Trainingsdaten besitzt, können spezialisierte Encoder Modelle sehr effizient sein.
Aktuelle Forschung zeigt sogar, dass vergleichsweise einfache Encoder Architekturen bei hierarchischer Textklassifikation mit komplexeren Ansätzen konkurrieren können.¹
Large Language Models werden dagegen interessant, wenn Kategorien häufig verändert werden oder nur wenige gelabelte Trainingsdaten verfügbar sind.
Eine Untersuchung zur Klassifikation wissenschaftlicher Dokumente im industriellen Maßstab zeigt genau dieses Problem. Dort müssen Hunderttausende Dokumente über Tausende dynamische Kategorien eingeordnet werden. Die Autoren kombinieren Large Language Models mit Dense Retrieval und nutzen Zero Shot und Few Shot Verfahren, um neue oder veränderte Kategorien flexibler abzubilden, ohne für jede Änderung ein vollständiges Modelltraining durchführen zu müssen.²
Die Wahl des Modells hängt deshalb stark vom Anwendungsfall ab.
Wann klassische Modelle besonders sinnvoll sind
Spezialisierte Modelle bieten Vorteile, wenn:
• Kategorien langfristig stabil sind
• viele gelabelte Trainingsbeispiele vorhanden sind
• sehr viele Dokumente verarbeitet werden
• geringe Latenz wichtig ist
• Ressourcen oder Kosten begrenzt werden sollen
• die Entscheidung reproduzierbar sein muss
Beispielsweise kann ein Unternehmen einen Classifier trainieren, der eingehende Supportanfragen einer festen Anzahl von Servicekategorien zuordnet.
Wenn sich diese Kategorien selten verändern, besteht häufig kein Grund, für jede Anfrage ein großes generatives Modell einzusetzen.
Wann Zero Shot und Large Language Models interessant werden
Anders sieht es aus, wenn sich eine Taxonomie regelmäßig verändert.
Neue Produktkategorien können hinzukommen.
Abteilungen werden umstrukturiert.
Themen verändern sich.
Ein klassischer überwacht trainierter Classifier benötigt dann möglicherweise neue Trainingsbeispiele und erneutes Training.
Zero Shot Verfahren können Kategorien teilweise anhand ihrer Bezeichnung und Beschreibung interpretieren, ohne zuvor für jede Klasse zahlreiche Beispiele gesehen zu haben.
Das kann die Einführung neuer Kategorien erleichtern.
Allerdings entstehen dadurch neue Herausforderungen.
Bei sehr großen Taxonomien kann bereits die Anzahl möglicher Labels die Kontextgrenzen eines Sprachmodells überschreiten. Genau deshalb kombinieren aktuelle Ansätze Klassifikation und Retrieval: Zunächst werden plausible Kategorien eingegrenzt, anschließend wird die eigentliche Zuordnung vorgenommen.²
Klassifikation kann die Suche gezielt steuern
Ein Smart Classifier ist besonders interessant, wenn seine Ergebnisse mit anderen Search Funktionen verbunden werden.
Dynamic Faceting
Automatisch erkannte Kategorien können als Filter zur Verfügung gestellt werden.
Intent Detection
Nicht nur Dokumente, sondern auch Suchanfragen können klassifiziert werden.
Federated Search
Ein erkannter Dokumenttyp oder Themenbereich kann bestimmen, welche Datenquelle relevant ist.
Automatic Re Ranking
Kategorien können zusätzliche Ranking Signale liefern.
Question Answering
Ein System kann Antworten gezielt aus bestimmten Dokumenttypen oder Themenbereichen beziehen.
Personalization
Kategorien können dabei helfen, Inhalte abhängig vom Nutzungskontext zu priorisieren.
Der Smart Classifier wird dadurch zu einer Komponente, die Inhalte für weitere AI Search Funktionen besser interpretierbar macht.
Ein praktisches Beispiel aus dem Kundenservice
Ein Unternehmen besitzt 50.000 Serviceartikel. Historisch wurden diese sehr unterschiedlich gepflegt.
Manche Artikel enthalten ausführliche Metadaten, andere nur Titel und Text. Ein Smart Classifier kann den Bestand analysieren und beispielsweise automatisch folgende Kategorien erzeugen oder bestehende Kategorien zuweisen:
Produkttyp: Kaffeemaschine
Problem: Wasserverlust
Komponente: Wassertank
Dokumentart: Troubleshooting
Servicephase: Reparatur
Ein Kunde sucht später:
„Meine Maschine verliert Wasser unter dem Tank.“
Die Suchmaschine kann jetzt nicht nur Text und Vektoren vergleichen.
Sie besitzt zusätzliche strukturierte Hinweise.
Diese können für Filter, Retrieval und Ranking verwendet werden.
Was passiert bei sehr großen Taxonomien?
Viele reale Klassifikationsprobleme bestehen nicht aus zehn oder zwanzig Kategorien.
Bei Produkten, Forschung, Recht oder großen Wissensbeständen können Tausende möglicher Klassen existieren.
Hinzu kommt, dass Kategorien nicht statisch bleiben.
Sie werden:
• ergänzt
• zusammengeführt
• umbenannt
• verschoben
• entfernt
Gerade hier wird die Architektur entscheidend.
Die Untersuchung von Tabatabaei und Kollegen zeigt, dass industrielle Dokumentklassifikation mit Hunderttausenden Dokumenten und Tausenden dynamischen Labels andere Anforderungen stellt als kleine Benchmark Aufgaben.²
Ein Smart Classifier muss deshalb nicht nur korrekt klassifizieren.
Er muss auch mit Veränderungen der Taxonomie umgehen können.
Gute Klassifikation braucht gute Kategorien
Ein sehr leistungsfähiges Modell kann eine schlechte Taxonomie nicht vollständig kompensieren.
Wenn Kategorien unklar definiert sind, werden auch die Zuordnungen unsicher.
Problematisch sind beispielsweise:
Überlappende Kategorien
„Softwareproblem“ und „Technischer Fehler“
Uneinheitliche Granularität
„IT“ neben „Passwort zurücksetzen“
Unklare Begriffe
„Sonstiges“, „Allgemein“, „Weitere Informationen“
Sehr seltene Kategorien
Klassen mit nur wenigen Beispielen sind schwieriger zuverlässig zu lernen.
Deshalb beginnt Smart Classification häufig nicht beim Modell, sondern bei der Frage:
Welche Kategorien sind für Suche und Geschäftsprozess tatsächlich hilfreich?
Wie lässt sich ein Smart Classifier bewerten?
Bei Klassifikation werden häufig Kennzahlen wie Precision, Recall und F1 Score verwendet.
Bei hierarchischen Taxonomien reicht eine einfache Betrachtung jedoch nicht immer aus.
Angenommen, die korrekte Kategorie lautet:
Technik → Hardware → Notebook
Das System klassifiziert:
Technik → Hardware
Ist das vollständig falsch?
Oder teilweise richtig?
Hierarchische Evaluation berücksichtigt solche Beziehungen.
Eine Untersuchung zur Evaluation hierarchischer Textklassifikation zeigt, dass die Wahl der Metrik und der Inferenzstrategie erhebliche Auswirkungen auf die Bewertung eines Modells haben kann. Die Autoren warnen deshalb davor, hierarchische Klassifikation lediglich wie eine gewöhnliche flache Multi Label Aufgabe zu evaluieren.³
Für den praktischen Einsatz bedeutet das:
Die Qualitätsmetrik muss zur Taxonomie und zum eigentlichen Anwendungsfall passen.
Automatisierung braucht eine Unsicherheitsgrenze
Nicht jede Klassifikation sollte automatisch übernommen werden. Ein sinnvoller Smart Classifier kann mit Konfidenzwerten arbeiten.
Bei hoher Sicherheit:
Kategorie automatisch vergeben
Bei mittlerer Sicherheit:
Vorschlag zur Prüfung anbieten
Bei niedriger Sicherheit:
manuelle Klassifikation oder keine Zuordnung
Das ist besonders bei sensiblen Dokumenten wichtig.
Ein falsch klassifiziertes Marketingdokument ist meist weniger kritisch als eine falsch eingeordnete rechtliche Richtlinie.
Die notwendige Genauigkeit hängt also vom Risiko der nachgelagerten Nutzung ab.
Wo Smart Classification besonders sinnvoll ist
Enterprise Search
Dokumente können automatisch nach Themen, Abteilungen und Dokumenttypen strukturiert werden.
E Commerce
Produkte lassen sich Kategorien, Einsatzbereichen oder Merkmalen zuordnen.
Kundenservice
Tickets, FAQs und Supportartikel können nach Problemtyp und Zuständigkeit kategorisiert werden.
Wissensmanagement
Unstrukturierte Dokumentbestände erhalten zusätzliche Metadaten und Themenzuordnungen.
Dokumentenmanagement
Dokumentarten wie Verträge, Rechnungen, Richtlinien und Anleitungen können automatisch erkannt werden.
AI Search und RAG
Klassifikationen können verwendet werden, um Retrieval gezielt auf bestimmte Inhaltsgruppen einzuschränken oder zu priorisieren.
Fazit: Smart Classification schafft Struktur, bevor gesucht wird
Suchqualität hängt nicht nur davon ab, wie gut eine Suchanfrage verstanden wird. Sie hängt auch davon ab, wie gut das System die vorhandenen Inhalte kennt.
Ein Smart Classifier kann Dokumente und andere Inhalte automatisch Kategorien zuordnen und dadurch zusätzliche Struktur erzeugen. Diese Struktur kann anschließend für Filter, Retrieval, Routing, Ranking und weitere AI Search Funktionen verwendet werden. Dabei gibt es nicht das eine richtige Klassifikationsmodell.
Für stabile Kategorien können spezialisierte Encoder Modelle effizient und leistungsfähig sein. Bei dynamischen Taxonomien und wenigen Trainingsbeispielen können Zero Shot, Few Shot und LLM basierte Ansätze Vorteile bieten. Entscheidend bleiben die Qualität der Taxonomie, geeignete Trainingsdaten und eine Evaluation, die den tatsächlichen Anwendungsfall berücksichtigt.
Smart Classification macht aus unstrukturierten Inhalten verwertbare Signale für eine präzisere Suche.
Die Quasiris Search Cloud unterstützt Smart Classification und ermöglicht es, Inhalte und Dokumente mithilfe von Machine Learning Modellen automatisch zu klassifizieren und für weitere Suchfunktionen nutzbar zu machen.
Sie möchten vorhandene Inhalte automatisch strukturieren und zusätzliche Metadaten für Ihre Suche erzeugen? Sprechen Sie mit den Search Experten von Quasiris über Ihren Anwendungsfall.
💡 Wie gut ist Ihre Suche wirklich?
Unpassende Treffer, hohe Nulltrefferquoten und aufwendige manuelle Rankingregeln sind häufig ein Hinweis darauf, dass eine Suche ihr Potenzial noch nicht vollständig ausschöpft.
Mit unserem kostenlosen Search Review erhalten Sie eine erste Einschätzung zur Qualität Ihrer bestehenden Suche und zu möglichen Optimierungspotenzialen.
↓ Jetzt kostenloses Search Review anfragen ↓
Quellen
¹ Karl, F., & Scherp, A. (2025). HYDRA: A multi head encoder only architecture for hierarchical text classification. In Proceedings of the 2025 Conference on Empirical Methods in Natural Language Processing (pp. 9292–9303). Association for Computational Linguistics. https://doi.org/10.18653/v1/2025.emnlp-main.472
² Tabatabaei, S. A., Fancher, S., Parsons, M., & Askari, A. (2025). Can large language models serve as effective classifiers for hierarchical multi label classification of scientific documents at industrial scale? In Proceedings of the 31st International Conference on Computational Linguistics: Industry Track (pp. 163–174). Association for Computational Linguistics. https://aclanthology.org/2025.coling-industry.14/
³ Plaud, R., Labeau, M., Saillenfest, A., & Bonald, T. (2024). Revisiting hierarchical text classification: Inference and metrics. In Proceedings of the 28th Conference on Computational Natural Language Learning. Association for Computational Linguistics. https://aclanthology.org/2024.conll-1.18/